744B 模型塞进笔记本
当 GLM-5.2 这种 744B 参数量级的巨型模型还在数据中心里排队跑分时,一位开发者在 GitHub 上贴出一行代码,声称在自己的慢电脑上让它跑起来了。这不只是技术突破,是对”大模型必须跑在高端硬件上”这一行业共识的彻底颠覆。
一个慢电脑引发的革命
JustVugg 在 Hacker News 上发的标题是”Getting GLM 5.2 running on my slow computer”。这行字在技术圈炸开了锅。900 多点赞,数百条评论,GitHub 仓库几天内从 0 飙到 27k stars。
核心问题其实很朴素:真的需要$30,000 的机器才能运行一个能塞进$60 SSD 的模型吗?
流式传输的魔法
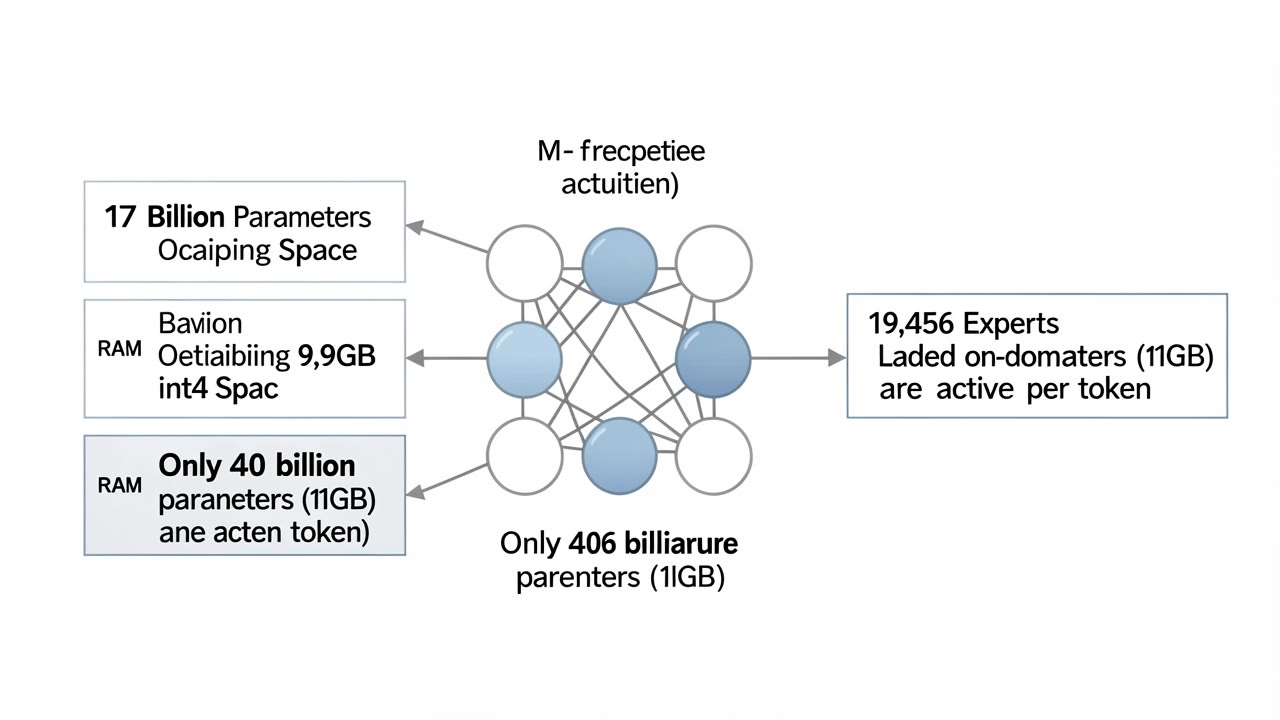
Colibri 的架构设计堪称精妙。它采用纯 C 实现,零依赖,所有专家模型从磁盘流式传输。稠密部分约 17B 参数,占用 9.9GB int4 空间,常驻 RAM。剩下的 19,456 个专家,总共约 370GB,按需从磁盘加载。
支持 VRAM、RAM、存储三级内存管理,带 LRU 缓存和热数据预测。
这意味着744B 参数中每 token 仅激活约 40B,活跃部分只有 11GB 变化。这就是 MoE 架构的魅力所在。
在笔记本上跑起来
在 12 核笔记本、25-32GB 内存、零 GPU 的配置下,Colibri 成功运行 GLM-5.2。初始速度约 0.1 tokens/s,但正在优化 MTP 多 token 预测。
- FreeBSD 官方端口收录,维持者 Yuri 的描述是”纯 C,零依赖,从磁盘流式传输专家”
- 定位为轻量级、质量保留的 MoE 运行时
- 将 VRAM、RAM、存储视为单一管理内存层次
- 分发文件仅 3MB
速度瓶颈:初始约 0.1 tokens/s,但正在优化 MTP 多 token 预测。
争议与思考
开发者崇拜黑客精神 vs 实用用户质疑实际用途。有人分享 fork 版本可在 10GB 内存运行。技术讨论包括:madvise 预加载、专家预测优化、异步读取。
Colibri 的发布引发了行业思考:我们是否需要将模型能力与硬件规格绑定?当 744B 模型可以运行在消费级设备上,“高端硬件”的定义本身是否需要重写?
影响与未来
技术验证与推广:YouTube 技术解析视频展示在 12 核笔记本、25-32GB 内存、零 GPU 上运行 GLM-5.2。强调这是”完整思维转变”:不需要数据中心测试模型。
社区贡献显著:多人提供改进建议和权重转换。GitHub 仓库在数天内从 0 到 27k stars,验证了 MoE 架构特性。
行业传播:X 项目主账号发布,列举 7 个支持的开源 MoE 模型:GLM-5.2、GLM-5.3-Flash、Inkling、Kimi K3、DeepSeek V4 Flash、Qwen3.6、OLMoE。参数范围从 744B 到 2.8T,运行在自有硬件上。
LinkedIn 开发者传播,多位 AI 工程师分享该项目。标签:localllm、aiengineering、ollama、frontier-moe。强调”纯 C、零依赖、磁盘流式”的核心特性。
总结与展望
从 Hacker News 的病毒式传播到 FreeBSD 官方收录,Colibri 证明了MoE 架构可以真正落地。当 744B 模型可以在笔记本上运行,大模型的民主化进程加速。
核心突破在于:不需要$30,000 机器就能运行能塞进$60 SSD 的模型。这不仅是技术突破,更是对行业认知的颠覆。
— END —
LC 智趣厅 · 科技与生活的交点
ihygg.cn
