Hindsight:会学习的Agent记忆
从”记得”到”学会”
Agent 记忆是今年大模型应用最热的基建赛道之一。向量数据库加检索的”外挂记忆”方案已经跑了一年,但普遍卡在”只存不学”:存得下,却学不会。Vectorize 的 Hindsight 走的是另一条路——它不满足于让 Agent 记住,而是要求 Agent 在记忆之上形成并更新自己的”信念”。仓库自 2025 年 12 月中旬首次公开以来,GitHub 星标已冲上 33.8k,是近期少见的现象级开源 Agent 基建项目,也是与近期多篇 Agent 工具选题方向完全不同的记忆层基建。
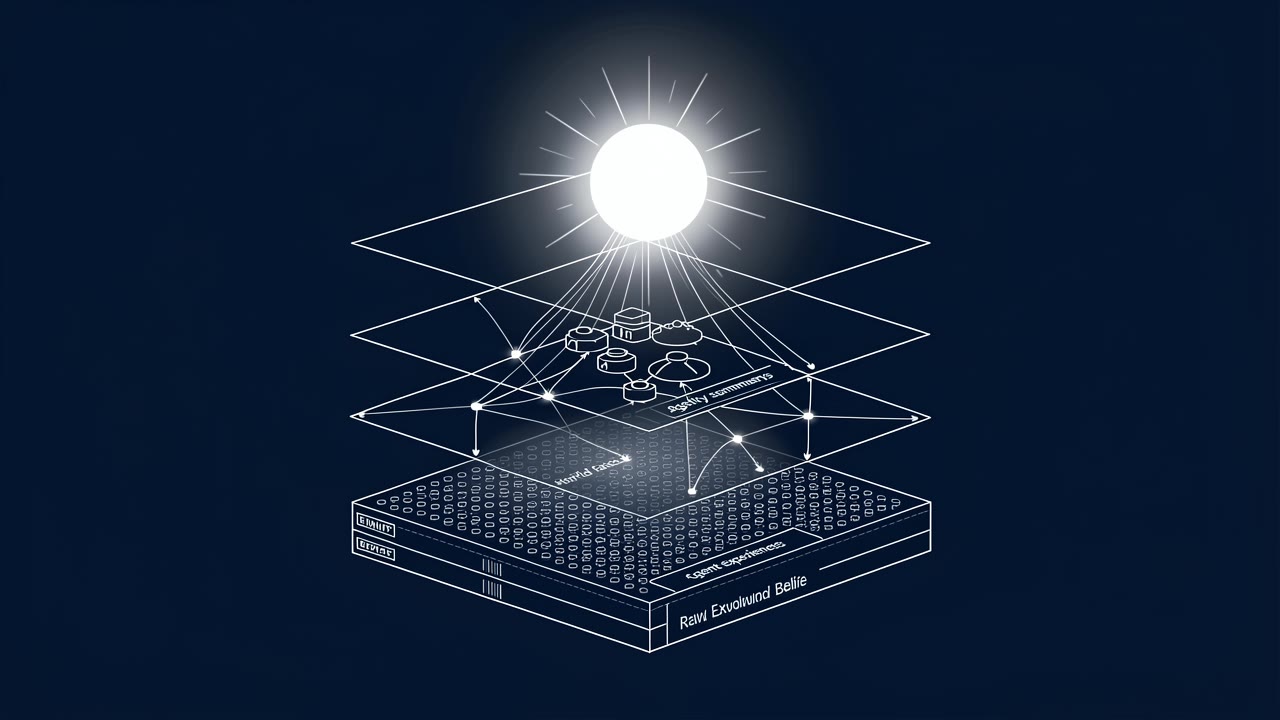
项目事实:四网三操作
Hindsight 官方定位是”an agent memory system built to create smarter agents that learn over time”,主打 learning 而非 remember。
架构上,它把记忆组织成四个逻辑网络:
- world facts:世界事实层
- agent experiences:Agent 经验层
- synthesized entity summaries:实体摘要层
- evolving beliefs:会随时间演化的信念层
对外暴露三大核心操作:retain 把原始交互转成结构化、时间感知的记忆;recall 在 token 预算内检索;reflect 则负责推理并更新信念。这套设计刻意贴近人类记忆的 contextual 与 time-aware 特性。
工程侧,它通过 HINDSIGHT_API_LLM_PROVIDER 支持 25 以上 LLM 供应商,含 OpenAI、Anthropic、Gemini、Ollama、LM Studio 等本地方案;客户端覆盖 Python(pip install hindsight-client)、Node、Go 与 CLI,集成列表横跨 Claude Code、Codex、Cursor、GitHub Copilot、Cline、Aider、Zed、LangGraph、LlamaIndex、CrewAI、n8n、Zapier。仓库当前 33.8k stars、4.0k forks、265 位贡献者,MIT 许可,最新 release 为 2026 年 9 月 21 日的 v0.10.1,共 70 个版本。
数据与论文:LongMemEval 上的 91.4%
项目配套一篇 arXiv 技术报告《Hindsight is 20/20: Building Agent Memory that Retains, Recalls, and Reflects》,作者来自 Vectorize、《华盛顿邮报》与 Virginia Tech,摘要给出的数字相当能打:
- Hindsight 配开源 20B 模型,在 LongMemEval/LoCoMo 上把整体准确率从 39% 提到 83.6%,同 backbone 下超过 full-context GPT-4o
- 换更大 backbone 后,LongMemEval 达 91.4%,LoCoMo 达 89.61%,此前最强开源系统为 75.78%
- 官方 LongMemEval 对比表:full-context OSS-20B 39.0%、full-context GPT-4o 60.2%、Zep 71.2%、Supermemory 85.2%、Hindsight(OSS-20B)83.6%、Hindsight(Gemini-3)91.4%,自述较 full-context 基线提升 44.6 个百分点
论文同时披露,Hindsight 自身的事实抽取、记忆图构建与检索由 GPT-OSS-120b 驱动。0.4.0 版本又加入两级学习体系:Mental Models(用户策划的常见问题摘要,需 API 手动创建)与 Observations(自动沉淀的观察),让”信念更新”从论文概念落到了产品功能。
对 Agent 生态的影响
记忆是长程 Agent 的生死线。一个只会遗忘的 Agent 做不了真正的连续任务:跨天的项目跟进、个人助理的长期偏好、多 Agent 协作中的共享上下文,全都依赖”记得并且能学”。Hindsight 把记忆从”存储层”升级成”认知层”,方向上与 Anthropic 的 memory 工具、各大厂的上下文工程路线形成竞争,但它的开源属性让它更像事实标准候选。
33.8k 星标与 70 个 release 说明社区已经用脚投票。对做 Agent 产品的团队,这意味着记忆层第一次有了不绑定单一云厂商、可本地跑的开源选项;对做 Agent 框架的团队,MIT 许可加多语言客户端意味着可以直接内嵌,不必自研。从竞争格局看,Zep 与 Supermemory 这类闭源商业方案在 LongMemEval 上已被开源的 Hindsight 追平甚至反超,记忆层正在复制当年向量数据库”闭源先行、开源反超”的剧本,后续值得盯的是它对多 Agent 共享记忆和企业级权限隔离的补齐进度。
上手准备与已知限制
准备:先跑通官方 Quickstart,接入成本不高,核心步骤如下:
- 安装客户端:Python 用 pip install hindsight-client -U,Node 用 npm install @vectorize-io/hindsight-client,也提供 Go 与 CLI 版本
- 配置 LLM 供应商:设置 HINDSIGHT_API_LLM_PROVIDER 及相关密钥,可选 openai、anthropic、gemini 或本地的 ollama、llamacpp 等
- 接入现有 Agent 框架:按官方集成列表对接 Claude Code、Cursor、LangGraph、CrewAI 等,把 retain 与 recall 挂进 Agent 的记忆调用链
限制:
- 基准数字来自厂商论文与博客,独立第三方复现仍少,引用时需注明出处
- 记忆系统自身依赖 GPT-OSS-120b 级别模型驱动,小模型场景下的效果衰减待验证
- Mental Models 需要手动通过 API 创建,”自动学习”目前部分依赖 Observations 的自动沉淀,并非完全免维护
总结
Hindsight 是 2026 年 Agent 记忆赛道最值得盯的开源项目:四网三操作把”学习”写进了架构,91.4% 的 LongMemEval 成绩把开源方案推到了 SOTA,33.8k 星标和 265 位贡献者证明它不是 demo,而是一套有论文、有基准、有社区的产品化系统。记忆决定 Agent 能走多远,Hindsight 是目前最接近”会学习的记忆”的开源答案。
— END —
LC 智趣厅 · 科技与生活的交点
ihygg.cn
