知识编译:LLM Wiki 新范式
你是否还在为海量 PDF、网页剪藏、会议录音和 Office 文档构建知识库而烦恼?传统 RAG(检索增强生成)每次查询都是从零开始,无法积累知识。
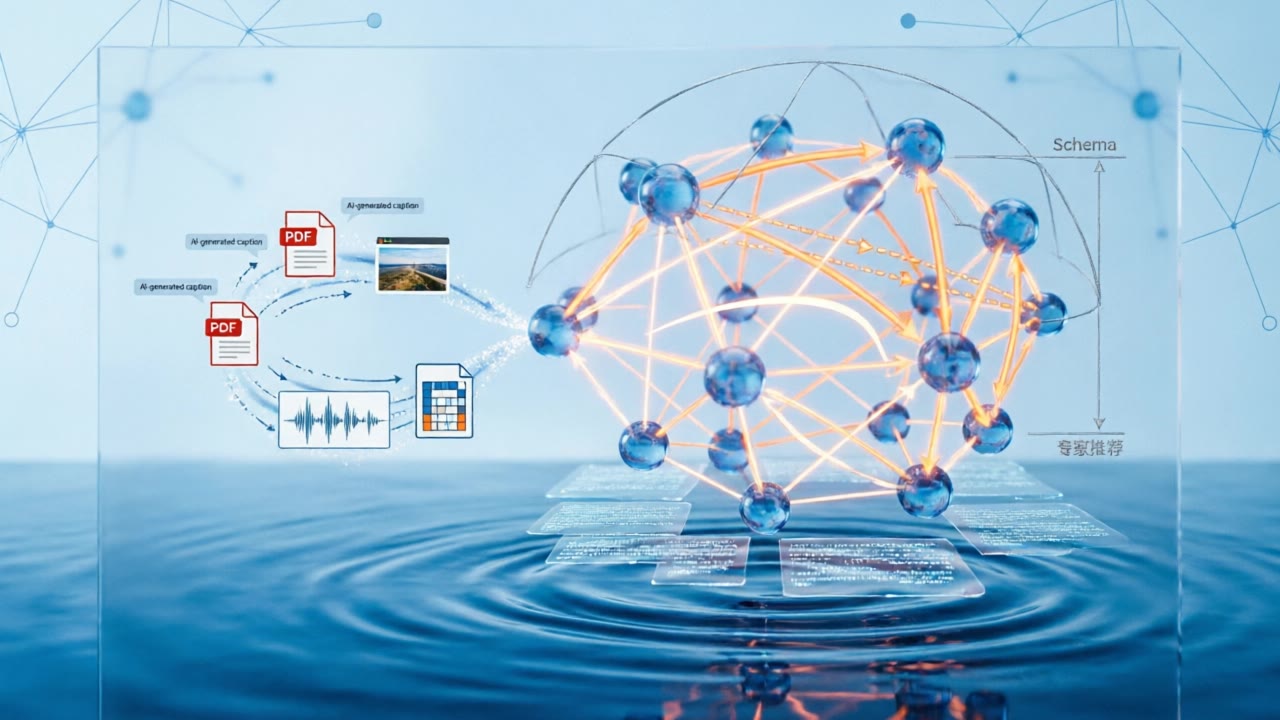
nashsu/llm_wiki 提供了一种全新思路:不再将资料作为被动检索对象,而是主动“编译”成可进化、互链的组织化知识库。
从 RAG 到知识编译的范式转移
传统 RAG 每次查询都是从零开始,答案碎片化。LLM Wiki 知识可积累,支持本地编辑、互链引用,形成可进化的知识网络。GitHub Daily 在 X 上推荐 LLM Wiki 开源工具时强调,“编译成 Wiki”思路与传统 RAG 的区别在于知识的持久化和可演进性。
核心突破在于”增量构建”与”知识图谱”的结合。 项目通过四信号知识图谱(直接链接、来源重叠、Adamic-Adar、类型亲和)自动发现知识关联,支持 Louvain 社区检测自动聚类,并标记矛盾和知识空白。Ingest 流程中,每个新源会触发 10-15 个 wiki 页更新,逐步完善知识网络。
三层架构设计确保可控性
Raw Sources(源)存储原始资料,Wiki Pages(页面)完全由 LLM 掌控生成内容,Schema(协议)定义人与 LLM 的交互规则。这种设计让本地编辑成为可能,你可以用 VS Code 或 Obsidian 直接修改 LLM 生成的内容,形成”本地优先”的工作流。
Ingest 流程:新源→LLM 讨论→生成摘要页→更新索引→标记矛盾→记录 Log(单个源触发 10-15 个 wiki 页更新)。
四信号知识图谱(直接链接、来源重叠、Adamic-Adar、类型亲和)自动发现知识关联。
多模态摄入与图谱洞察
项目支持 PDF、Office、EPUB、音视频等多格式导入,自动提取 PDF 内嵌图片并调用视觉模型生成描述。图谱洞察功能可发现惊奇连接与知识空白,一键触发 Deep Research,实现从知识检索到知识编译的范式转移。
实践建议与限制
项目支持 Windows、macOS、Linux 多平台安装,附带 Chrome 扩展插件(llm-wiki-extension-0.6.11.zip, 49.4KB)。但需明确:并非所有资料都能完美转化,复杂图表、多语言混合文档可能需要人工校验。
四个关键步骤:
- 准备阶段:安装应用(支持 14 种安装包),配置 API 或 Ollama 本地模型
- 导入资料:拖入 PDF、Office 或 Chrome 剪藏,支持多语言
- 生成 Wiki:LLM 自动讨论并生成摘要页、更新索引、标记矛盾
- 本地编辑:用 Obsidian 或 VS Code 编辑内容,重建索引
数据表现验证热度
项目月访问量超 150K,TypeScript 周榜第 18 名,2026 年 8 月 30 日排名#9。17,210+ stars、2,043 forks,856 次 commit 由 36 位贡献者共同维护,持续活跃。
适合人群:研究者、内容创作者、技术团队。
局限提醒:GPL-3.0 协议限制商业用途,复杂文档需人工校验,多语言混合内容可能影响 LLM 理解准确性。
— END —
LC 智趣厅 · 科技与生活的交点
ihygg.cn
